Karpathy 的LLM wiki | 如何用 LLM 构建个人知识库
今年4月2日,安德烈·卡帕西在X上发了一条帖子,讲他最近在用一种新方式管理研究资料,这条帖子获得了超过1600万次浏览、数千次转发,引来数百条来自AI从业者和研究者的回复,反响之大连他自己都没料到,两天后又追发了一份更详细的说明文档,把整套方法的架构、工具和用法完整讲清楚。
他是斯坦福博士出身的AI研究者,OpenAI创始成员之一,之后在特斯拉出任AI总监,主导过Autopilot的计算机视觉系统,2023年回到OpenAI参与GPT-4的改进工作,2024年离职后创办了AI教育公司Eureka Labs。
他用一句话概括了整套系统的分工:Obsidian是IDE,LLM是程序员,wiki是代码库。知识不是被查询出来的,是被持续维护、持续编译出来的,就像代码库不是每次运行时现写,是靠版本迭代往前滚动的。
01 要解决的问题:RAG式问答,知识不会积累
理解这套方法之前,先要弄清楚它在解决什么。大多数人现在用LLM处理自己的文档,走的是RAG(检索增强生成)的路子:上传一堆文件,提问时系统检索出相关片段,喂给LLM生成答案。NotebookLM、ChatGPT的文件上传功能,走的都是这条路。
问题出在积累这件事上。LLM在每次提问时都要从零重新发现知识,没有真正的积累。今天问一个需要综合五份文档才能回答的问题,系统要现场把相关片段找出来、拼在一起;明天问类似的问题,同样的活儿要再做一遍,什么都没有真正沉淀下来。
Karpathy的方案,是让LLM在新材料进来的那一刻就把处理工作做完,写进一个持续存在、持续被维护的wiki里,而不是留到提问那一刻才现场处理。这个区别体现在几个具体维度上:知识什么时候被加工,RAG是提问那一刻,wiki是材料进来那一刻;概念之间的交叉引用,RAG靠每次提问现场发现,wiki提前建好、持续维护;材料之间出现的矛盾,RAG大概率不会被察觉,wiki在录入阶段就被标记;产出的东西,RAG是一次性的聊天回复,用完即弃,wiki是持久存在、可以反复回来编辑的markdown文件。
02 三层架构
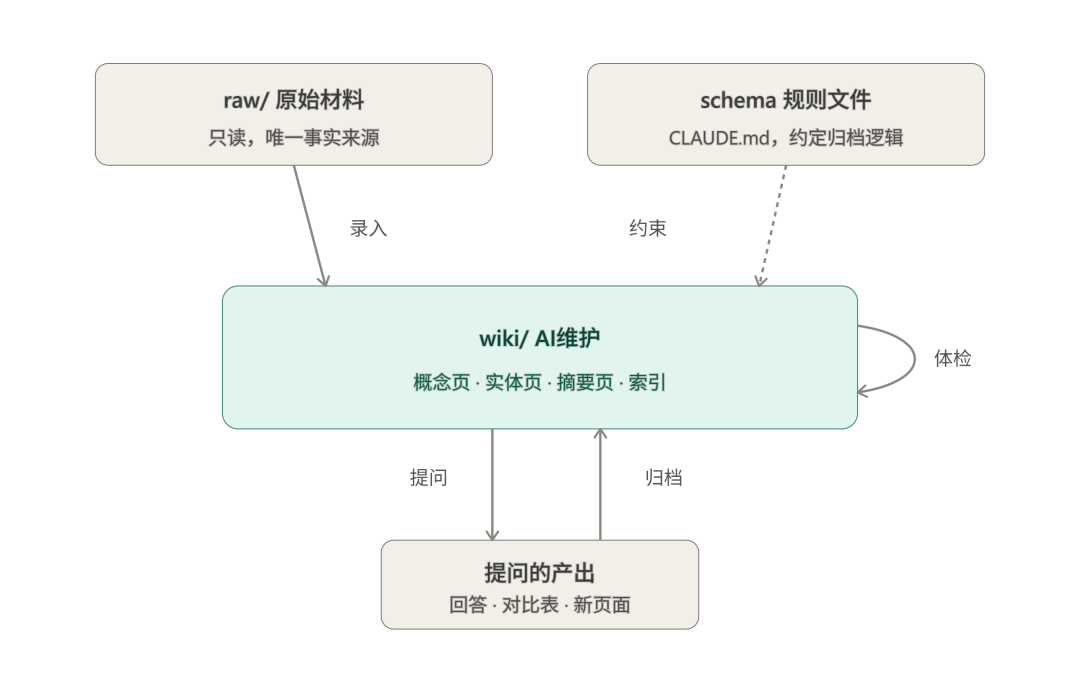
整套系统分三层。
raw/是原始材料层,存放收集来的源文档——文章、论文、代码仓库说明、数据集、图片,这些材料不可变,LLM只能读、不能改,是唯一的事实来源。这一层存在的意义是留一条能随时核对的底线:wiki层如果写错了什么,永远可以回到raw/去校对。
wiki/是AI生成层,由LLM生成和维护的markdown文件目录,内容包括各类摘要、实体页、概念页、对比页、一份总览,这一层完全由LLM所有,人只读,LLM来写。目录结构大致是这样:概念类文章放在concepts/,人物或机构之类的实体放在entities/,每份原始材料对应的摘要放在sources/,跨材料的对比放在comparisons/,此外还有一份index.md作为总目录,一份log.md记录每次操作。
schema/是规则层,通常是一份CLAUDE.md(用Claude Code时)或AGENTS.md(用OpenAI Codex时)文件,告诉LLM这个wiki的结构、约定,以及处理新材料、回答问题、维护wiki时该遵循的具体流程,是让LLM变成一个有纪律的wiki维护者、而不是一个泛泛聊天机器人的关键配置。没有这份文件,LLM每次都是从零理解你的知识库该怎么组织;有了它,LLM才会按固定的规则去归档、更新索引、保持前后一致。这份文件不是一次写完就定型的,是使用者和LLM在长期使用中一起打磨出来的,慢慢摸索出最适合自己这个领域的页面结构和工作流程。
03 三个操作:录入、提问、体检
录入是往raw/里加一份新材料,然后让LLM处理。这个动作往往不止是新建一页,一份来源可能牵动十到十五个已有页面的联动更新:新建摘要页,更新相关的概念页和实体页,如果新材料和已有内容存在矛盾,会被标记出来。
提问是向wiki提问题,LLM会去搜索相关页面、阅读、综合出答案,答案的形式可以是一篇markdown文章、一张对比表格、一份幻灯片,甚至一张图表。值得留意的一点是,好的回答本身值得被归档成新的wiki页面,一次有价值的分析、一次发现的关联,不应该消失在聊天记录里——这样一来,使用者自己的探索过程也在持续积累,不只是外部材料在积累。
体检是定期请LLM给整个wiki做一次一致性检查:扫描页面之间的矛盾、找出没有被任何页面引用的孤立页面、找出反复被提到但还没有独立页面的重要概念,还会建议下一步该去研究什么、该找什么新材料。这一步和前两个操作性质不同,录入和提问处理的是单点信息,体检处理的是整个知识库的一致性,这是过去所有个人知识管理方法都没有真正解决过的能力——卡片盒笔记法的创始人卢曼要在几万张卡片里靠自己发现矛盾和遗漏,靠的是几十年浸淫出来的记忆力,普通人做不到这个规模的人工审计。
04 配套工具,不止Obsidian
Obsidian负责浏览和可视化,图谱视图是查看wiki整体形状最直观的方式,哪些页面是枢纽、哪些是孤岛,一眼能看出来。Obsidian Web Clipper是浏览器插件,能把网页文章直接转成markdown,适合快速把网上看到的材料收进raw/。qmd是一款本地markdown搜索引擎,结合关键词检索、向量语义检索和LLM重排序,全部在本地运行,不需要联网——小规模时index.md就够用了,qmd在wiki规模变大、超出索引文件能装下的范围之后才真正派上用场。Marp能把wiki内容直接生成markdown格式的幻灯片;Dataview是一款Obsidian插件,能对页面的元数据做类似数据库查询的操作;Git给整个wiki提供版本管理,wiki本质上就是一个存着markdown文件的git仓库,版本历史、分支、协作这些能力是白得的。
05 更早的源头:1945年的一个未完成设想
Karpathy在文档结尾提到了这套想法的历史源头,他认为这个想法在精神上,和范内瓦·布什1945年提出的Memex构想是相通的。布什是二战期间美国科学研究与发展办公室的负责人,1945年在《大西洋月刊》发表文章,设想了一台叫Memex的桌面设备,能让个人存储自己的全部书籍和记录,并在文档之间建立联想性的路径。这个设想后来直接启发了鼠标的发明者道格拉斯·恩格尔巴特,以及超文本概念的提出者泰德·尼尔森,但互联网最终走向了公开、庞杂的方向,不是布什设想的私人、精心整理的方向。Karpathy认为,他没能解决的问题是谁来做维护,而LLM解决了这个问题——LLM Wiki某种程度上是在把这个八十年前没走通的设想重新捡起来。
06 五个场景,实现方式各有不同
个人知识库:追踪自己的目标、健康状况、心理状态、自我提升,归档日记、文章、播客笔记,随着时间推移建立一幅关于自己的结构化图景。
深度研究:在一个主题上花几周到几个月持续钻研,阅读论文、文章、报告,渐进式地建立一份完整的wiki,并且带着一个不断演化的论点往前推进。这是Karpathy本人最主要的用法,一个研究主题积累到了约100篇文章、40万字。
读书:每读完一章归档一次,逐渐建立起人物、主题、情节线的页面,读完之后得到一份丰富的伴读wiki,类似大量互相链接的条目构成的粉丝维基,只是这次交叉引用和维护的工作交给了AI。
团队/企业:由LLM维护的内部wiki,材料来自Slack讨论、会议记录、项目文档、客户通话,可能配有人工在环节里审核更新,wiki能保持及时,是因为LLM做了团队里没人愿意做的维护工作。
其他:竞品分析、尽职调查、旅行规划、课程笔记、爱好类深度钻研,只要是长期持续积累材料、又希望它们被组织起来而不是散落各处的场景,这套模式都适用。
07 它没有解决什么
讲完能做什么,也要老实讲清楚边界在哪。已经有人实测后指出两个具体问题:一是规模限制,这套方案在一两百篇文章的量级下运作良好,超出这个量级,光靠index.md加上下文窗口会开始吃力;二是错误传播风险,如果LLM在录入阶段建立了一个错误的关联,这个错误会通过页面之间的反向链接扩散到更多页面,而且不容易被发现。这两点后面会用一整篇专门展开,这里先说清楚:它解决的是结构层的维护成本问题,不是判断力问题,什么材料值得录入、AI生成的内容哪些可信,仍然要靠使用的人自己判断。
理论不悬空,实践不盲目
欢迎关注公众号「数字化流程再造」